Active Recordは、生SQLを直接扱うことに慣れている開発者に、同じ操作をより読みやすく表現力の高い形で行う方法を提供します。
Active Recordは、多くのデータベースシステムで利用でき(MySQL、MariaDB、PostgreSQL、SQLiteなど)、メソッドベースのインターフェイスは、利用するデータベースにかかわらず統一されます。
本ガイドを最大限に活用するには、リレーショナルデータベース(RDBMS)とSQL(Structured Query Language)の知識があると役に立ちます。詳しくはこちらのSQLチュートリアルやRDBMSチュートリアルを参照してください(いずれも英語版です)。
他にも本ガイドに関連する便利なガイドが多数あります。
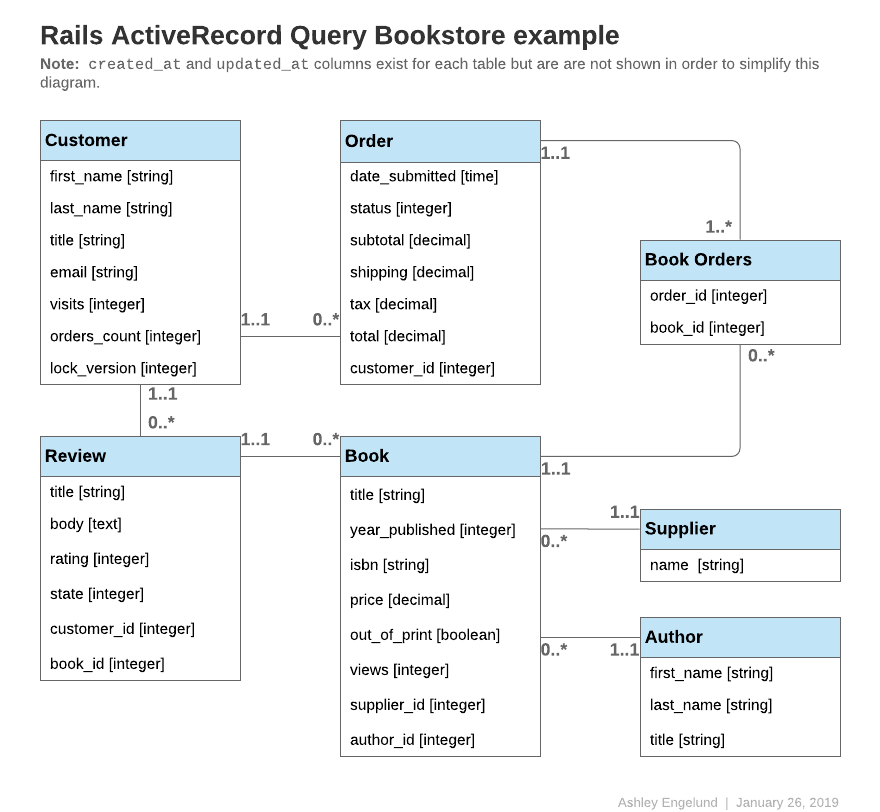
本ガイドで用いるコード例では、以下のモデルを参照します。
class Author < ApplicationRecord
  has_many :books, -> { order(year_published: :desc) }
end
class Book < ApplicationRecord
  belongs_to :supplier
  belongs_to :author
  has_many :reviews
  has_and_belongs_to_many :orders, join_table: "books_orders"

  scope :in_print, -> { where(out_of_print: false) }
  scope :out_of_print, -> { where(out_of_print: true) }
  scope :old, -> { where(year_published: ...50.years.ago.year) }
  scope :out_of_print_and_expensive, -> { out_of_print.where("price > 500") }
  scope :costs_more_than, ->(amount) { where("price > ?", amount) }
end
class Customer < ApplicationRecord
  has_many :orders
  has_many :reviews
end
class Order < ApplicationRecord
  belongs_to :customer
  has_and_belongs_to_many :books, join_table: "books_orders"

  enum :status, [:shipped, :being_packed, :complete, :cancelled]

  scope :created_before, ->(time) { where(created_at: ...time) }
end
class Review < ApplicationRecord
  belongs_to :customer
  belongs_to :book

  enum :state, [:not_reviewed, :published, :hidden]
end
class Supplier < ApplicationRecord
  has_many :books
  has_many :authors, through: :books
end
特に指定のない場合は、モデルのidを主キーとして使います。
Active Recordでは、データベースからオブジェクトを取り出すための検索メソッド(finder methods)を多数用意しています。これらの検索メソッドを利用することで、生のSQLを書かずにデータベースへの特定のクエリを実行するための引数を渡せるようになります。
このセクションでは、よく使われる検索メソッドの一部を扱います。
この他のクエリメソッド(whereやgroupなど)については、本ガイドで後述します。
クエリメソッドや検索メソッドの完全なリストについては、APIドキュメントのActiveRecord::QueryMethodsやActiveRecord::FinderMethodsを参照してください。
whereやgroupのようにコレクションを返す検索メソッドは、ActiveRecord::Relationインスタンスを返します。また、findやfirstなど1件のエンティティを検索するメソッドの場合、そのモデルの単一のインスタンスを返します。
ActiveRecord::Relationの主な操作を要約すると以下のようになります。
- 与えられたオプションを同等のSQLクエリに変換します。
- SQLクエリを発行し、該当する結果をデータベースから取り出します。
- 得られた結果を行ごとに同等のRubyオブジェクトとしてインスタンス化します。
- 指定されていれば、
after_findを実行し、続いてafter_initializeコールバックを実行します。
Active Recordには、単一のオブジェクトを取り出すためのさまざまな方法が用意されています。
findメソッドを使うと、与えられたどのオプションにもマッチする「主キー」に対応するオブジェクトを取り出せます。以下に例を示します。
# 主キー(id)が10の顧客を検索
store(dev)> customer = Customer.find(10)
=> #<Customer id: 10, first_name: "Ryan">
上と同等のSQLは以下のようになります。
SELECT * FROM customers WHERE (customers.id = 10) LIMIT 1
findメソッドでマッチするレコードが見つからない場合、ActiveRecord::RecordNotFound例外が発生します。
このメソッドを使って、複数のレコードを取り出すクエリも作成できます。これを行うには、findメソッドの呼び出し時に主キーの配列を渡します。これにより、指定の「主キー」にマッチするレコードをすべて含む配列が返されます。以下に例を示します。
# 主キー(id)が1と10の顧客を検索
store(dev)> customers = Customer.find([1, 10]) # OR Customer.find(1, 10)
=> [#<Customer id: 1, first_name: "Lifo">,
    #<Customer id: 10, first_name: "Ryan">]
上と同等のSQLは以下のようになります。
SELECT * FROM customers WHERE (customers.id IN (1,10))
findメソッドに渡された主キーの中に、どのレコードにもマッチしない主キーが1個でもあると、ActiveRecord::RecordNotFound例外が発生します。
テーブルで複合主キーを利用している場合、単一の項目を検索するときに配列を渡す必要があります。詳細や例については複合主キーガイドを参照してください。
takeメソッドはレコードを1件取り出します。どのレコードが取り出されるかは指定されません。以下に例を示します。
store(dev)> customer = Customer.take
=> #<Customer id: 1, first_name: "Lifo">
上と同等のSQLは以下のようになります。
SELECT * FROM customers LIMIT 1
takeメソッドは、マッチするレコードが見つからない場合にnilを返します。このとき例外は発生しません。
以下のように、takeメソッドで返すレコードの最大数を数値の引数で指定することもできます。
store(dev)> customers = Customer.take(2)
=> [#<Customer id: 1, first_name: "Lifo">,
    #<Customer id: 220, first_name: "Sara">]
上と同等のSQLは以下のようになります。
SELECT * FROM customers LIMIT 2
take!メソッドの動作は、マッチするレコードが見つからない場合にActiveRecord::RecordNotFound例外が発生する点を除いて、takeメソッドとまったく同じです。
takeメソッドではORDER BY句が指定されないため、取り出されるレコードはデータベースエンジンによって異なる可能性があります。明示的にソート順を指定していないSQLでは、どのレコードが返されるかが保証されません。
firstメソッドは、デフォルトでは主キー順の最初のレコードを取り出します。以下に例を示します。
store(dev)> customer = Customer.first
=> #<Customer id: 1, first_name: "Lifo">
上と同等のSQLは以下のようになります。
SELECT * FROM customers ORDER BY customers.id ASC LIMIT 1
firstメソッドは、マッチするレコードが見つからない場合にnilを返します。このとき例外は発生しません。
デフォルトスコープがorderメソッドを含んでいる場合、firstメソッドはその順序に沿って最初のレコードを返します。
以下のように、firstメソッドで返すレコードの最大数を数値の引数で指定することもできます。
store(dev)> customers = Customer.first(3)
=> [#<Customer id: 1, first_name: "Lifo">,
    #<Customer id: 2, first_name: "Fifo">,
    #<Customer id: 3, first_name: "Filo">]
上と同等のSQLは以下のようになります。
SELECT * FROM customers ORDER BY customers.id ASC LIMIT 3
モデルで複合主キーを利用している場合の検索メソッドや並び順について詳しくは、複合主キーガイドを参照してください。
コレクションの順序をorderメソッドで変更した場合、firstメソッドはorderで指定された属性に従って最初のレコードを返します。
store(dev)> customer = Customer.order(:first_name).first
=> #<Customer id: 2, first_name: "Fifo">
上と同等のSQLは以下のようになります。
SELECT * FROM customers ORDER BY customers.first_name ASC LIMIT 1
first!メソッドの動作は、マッチするレコードが見つからない場合にActiveRecord::RecordNotFound例外が発生する点を除いて、firstメソッドとまったく同じです。
lastメソッドは、(デフォルトでは)主キーの順序に従って最後のレコードを返します。以下に例を示します。
store(dev)> customer = Customer.last
=> #<Customer id: 221, first_name: "Russel">
上と同等のSQLは以下のようになります。
SELECT * FROM customers ORDER BY customers.id DESC LIMIT 1
lastメソッドは、マッチするレコードが見つからない場合にnilを返します。このとき例外は発生しません。
モデルで複合主キーを利用している場合の検索メソッドや並び順について詳しくは、複合主キーガイドを参照してください。
デフォルトスコープがorderメソッドを含んでいる場合、lastメソッドはその順序に沿って最後のレコードを返します。
lastメソッドで返すレコードの最大数を数値の引数で指定することも可能です。
store(dev)> customers = Customer.last(3)
=> [#<Customer id: 219, first_name: "James">,
    #<Customer id: 220, first_name: "Sara">,
    #<Customer id: 221, first_name: "Russel">]
上と同等のSQLは以下のようになります。
SELECT * FROM customers ORDER BY customers.id DESC LIMIT 3
orderを使って順序を変更したコレクションの場合、lastメソッドはorderで指定された属性に従って最後のレコードを返します。
store(dev)> customer = Customer.order(:first_name).last
=> #<Customer id: 220, first_name: "Sara">
上と同等のSQLは以下のようになります。
SELECT * FROM customers ORDER BY customers.first_name DESC LIMIT 1
last!メソッドの動作は、マッチするレコードが見つからない場合にActiveRecord::RecordNotFound例外が発生する点を除いて、lastメソッドとまったく同じです。
find_byメソッドは、与えられた条件にマッチするレコードのうち最初のレコードだけを返します。以下に例を示します。
store(dev)> Customer.find_by(first_name: "Lifo")
=> #<Customer id: 1, first_name: "Lifo">

store(dev)> Customer.find_by(first_name: "Jon")
=> nil
上の文は以下のようにも書けます。
Customer.where(first_name: "Lifo").take
上と同等のSQLは以下のようになります。
SELECT * FROM customers WHERE (customers.first_name = "Lifo") LIMIT 1
上のSQLにORDER BYがない点にご注意ください。find_byの条件が複数のレコードにマッチする場合は、レコードの順序を一貫させるために並び順を指定する必要があります。
find_by!メソッドの動作は、マッチするレコードが見つからない場合にActiveRecord::RecordNotFound例外が発生する点を除いて、find_byメソッドとまったく同じです。以下に例を示します。
store(dev)> Customer.find_by!(first_name: "does not exist")
ActiveRecord::RecordNotFound
上の文は以下のようにも書けます。
Customer.where(first_name: "does not exist").take!
モデルで複合主キーを利用している場合は、複合主キーガイドの条件で:idを指定する場合でfind_by(id:)の振る舞いを参照してください。
Active Recordは、テーブルで定義したあらゆるフィールド(属性とも呼ばれます)について検索メソッド(finder methods)を動的に提供します。
たとえば、Customerモデルにfirst_nameというフィールドがあると、何もしなくてもActive Recordによってfind_by_first_nameという検索メソッドが使えるようになります。
store(dev)> Customer.find_by_first_name("Bhumi")
=> #<Customer id: 25, first_name: "Bhumi">
同様に、Customerモデルにlockedがあれば、これにもfind_by_lockedという検索メソッドが「生えてきます」。
動的な検索メソッド名の末尾に!を追加すると、レコードが見つからない場合にActiveRecord::RecordNotFoundエラーが発生するようになります。
store(dev)> Customer.find_by_first_name!("Ryan")
ActiveRecord::RecordNotFound
first_nameとorders_countを両方使って検索したい場合は、以下のfind_by_first_name_and_orders_countのようにフィールド名同士を_and_でつなぐことで、これらの検索メソッドをチェインできます。
store(dev)> Customer.find_by_first_name_and_orders_count("Bhumi", 5)
=> #<Customer id: 25, first_name: "Bhumi">
Active Recordには、データベースから複数のレコードをまとめて取り出すメソッドが多数用意されています。
最も基本的なメソッドはallで、これはモデル内の全レコードを返します。
store(dev)> customers = Customer.all
=> [#<Customer id: 1, first_name: "Lifo">,
    #<Customer id: 2, first_name: "Fifo">, ...]
上のRubyコードは以下のSQLと同等です。
allメソッドが実際に返すのはActiveRecord::Relationオブジェクトです。そのおかげで、そこに追加のクエリメソッドをチェインできます。
たとえば、以下のようにwhereメソッドを組み合わせることで、レコードをフィルタで絞り込めます。
store(dev)> customers = Customer.all.where(active: true)
=> [#<Customer id: 1, first_name: "Lifo", active: true>,
    #<Customer id: 3, first_name: "Joe", active: true>]
これは以下のRubyコードと同じです。
customers = Customer.where(active: true)
以下は同等のSQLです。
SELECT * FROM customers WHERE (customers.active = true)
allはActiveRecord::Relationを返します。リレーションはlazy loading(遅延読み込み)されるので、allを最初に呼び出しても呼び出さなくても、クエリの振る舞いは変わりません。
RailsコンソールでCustomer.allを実行すると、クエリが即座に実行されているように見えます。これは、コンソールでは戻り値の表示にinspect呼び出しが使われているためです。inspectはレコードを読み込みます。
その他のorder、limit、groupなどのメソッドもクエリの絞り込みに使えます。これらのメソッドについて詳しくは、「レコードをフィルタで絞り込む」「レコードを並べ替える」「レコード件数を制限する」「レコードをグループ化する」セクションで後述します。
データセットの量が多い場合は、全レコードが一挙にメモリに読み込まれることを防ぐために、本セクションで後述するバッチ処理用のメソッドの利用を検討してください。
Active Recordはメソッドチェインをサポートしています。これにより、複数のActive Recordメソッドをシンプルな方法で次々に適用できるようになります。
文中でメソッドチェインを利用できるのは、その前のメソッドがActiveRecord::Relationオブジェクトを1つ返す場合です(all、where、joinsなど)。
単一のオブジェクトを返すメソッド(単一のオブジェクトを取り出すを参照)は文の末尾に置かなければなりません。
Active Recordのメソッドが呼び出されても、クエリが即座に生成されてデータベースに送信されるわけではありません。
クエリが送信されるのは、データが実際に必要になったときだけです。そのため、以下の個別の例は1個のクエリを生成します。
Railsコンソールでは、inspectを呼び出す形で結果を表示するため、クエリがその場で実行されるように見える場合があります。inspectは、リレーションオブジェクトを探索するだけでもクエリの実行をトリガーするためです。たとえば、コンソールでCustomer.where(active: true)と入力すると、デフォルトではリレーションが遅延読み込みされているにもかかわらず、クエリが即座に実行されて結果が表示されます。
Customer
  .select("customers.id, customers.last_name, reviews.body")
  .joins(:reviews)
  .where("reviews.created_at > ?", 1.week.ago)
上のコードから以下のようなSQLが生成されます。
SELECT customers.id, customers.last_name, reviews.body
  FROM customers
  INNER JOIN reviews
  ON reviews.customer_id = customers.id
  WHERE (reviews.created_at > "2019-01-08")
Book
  .select("books.id, books.title, authors.first_name")
  .joins(:author)
  .find_by(title: "Abstraction and Specification in Program Development")
上のコードから以下のようなSQLが生成されます。
SELECT books.id, books.title, authors.first_name
  FROM books
  INNER JOIN authors
  ON authors.id = books.author_id
  WHERE books.title = $1 [["title", "Abstraction and Specification in Program Development"]]
  LIMIT 1
1つのクエリが複数のレコードとマッチする場合、find_byは「最初」の結果だけを返し、他は返しません(上のLIMIT 1文を参照)。
以下のメソッドを用いて、データベース内のレコードや値を検索できます。
独自のSQLでレコードを検索したい場合は、find_by_sqlメソッドが使えます。このfind_by_sqlメソッドは、オブジェクトの配列を1つ返します。クエリがレコードを1つしか返さなかった場合にも配列が返されますのでご注意ください。たとえば、以下のクエリを実行したとします。
store(dev)> Customer.find_by_sql("SELECT * FROM customers INNER JOIN orders ON customers.id = orders.customer_id ORDER BY customers.created_at desc")
=> [#<Customer id: 1, first_name: "Lucas" ...>,
    #<Customer id: 2, first_name: "Jan" ...>, ...]
find_by_sqlは、カスタマイズしたデータベース呼び出しをシンプルな方法で提供し、インスタンス化されたレコードを返します。
find_by_sqlはlease_connection.select_allと深い関係があります。このselect_allはfind_by_sqlと同様、カスタムSQLを用いてデータベースから結果を取り出しますが、取り出した結果をインスタンス化しない点が異なります。このメソッドはActiveRecord::Resultクラスのインスタンスを1つ返します。このオブジェクトでto_aを呼ぶと、各レコードに対応するハッシュを含む配列を1つ返します。
store(dev)> Customer.lease_connection.select_all("SELECT first_name, created_at FROM customers WHERE id = \"1\"").to_a
=> [{"first_name"=>"Rafael", "created_at"=>"2012-11-10 23:23:45.281189"},
    {"first_name"=>"Eileen", "created_at"=>"2013-12-09 11:22:35.221282"}]
pluckは、指定したカラム名の値を現在のリレーションから配列として取得するときに利用できます。
引数としてカラム名のリストを渡すと、指定したカラムの値の配列を、対応するデータ型で返します。
store(dev)> Book.where(out_of_print: true).pluck(:id)
SELECT id FROM books WHERE out_of_print = true
=> [1, 2, 3]

store(dev)> Order.distinct.pluck(:status)
SELECT DISTINCT status FROM orders
=> ["shipped", "being_packed", "cancelled"]

store(dev)> Customer.pluck(:id, :first_name)
SELECT customers.id, customers.first_name FROM customers
=> [[1, "David"], [2, "Fran"], [3, "Jose"]]
pluckを使えば、以下のようなコードをシンプルなものに置き換えられます。
Customer.select(:id).map { |c| c.id }
# または
Customer.select(:id).map(&:id)
# または
Customer.select(:id, :first_name).map { |c| [c.id, c.first_name] }
上は以下に置き換えられます。
Customer.pluck(:id)
# または
Customer.pluck(:id, :first_name)
selectと異なり、pluckはデータベースから受け取った結果を直接Rubyの配列に変換します。ActiveRecordオブジェクトはビルドしません。
従って、このメソッドは大量の結果を返すクエリや利用頻度の高いクエリで使うとパフォーマンスが向上します。ただし、モデルメソッドのオーバーライドはpluckでは無効になります。以下に例を示します。
class Customer < ApplicationRecord
  def first_name
    "私は#{super}"
  end
end
store(dev)> Customer.select(:first_name).map(&:first_name)
=> ["私はDavid", "私はJeremy", "私はJose"]

store(dev)> Customer.pluck(:first_name)
=> ["David", "Jeremy", "Jose"]
単一テーブルのフィールド読み出しに加えて、複数のテーブルでも同じことができます。
store(dev)> Order.joins(:customer, :books).pluck("orders.created_at, customers.email, books.title")
さらにpluckは、selectなどのRelationスコープと異なり、クエリを直接トリガーするので、その後ろに他のスコープをチェインできません。
ただし、構成済みのスコープをpluckの前に置くことは可能です。
store(dev)> Customer.pluck(:first_name).limit(1)
NoMethodError: undefined method `limit' for #<Array:0x007ff34d3ad6d8>

store(dev)> Customer.limit(1).pluck(:first_name)
=> ["David"]
リレーションオブジェクトでincludesの値が含まれていると、eager-loadingが不必要なクエリでもpluckがeager-loadingを引き起こすことに注意が必要です。以下に例を示します。
store(dev)> assoc = Customer.includes(:reviews)
store(dev)> assoc.pluck(:id)
SELECT "customers"."id" FROM "customers" LEFT OUTER JOIN "reviews" ON "reviews"."id" = "customers"."review_id"
これを回避する方法の1つは、以下のようにincludesをunscopeすることです。
store(dev)> assoc.unscope(:includes).pluck(:id)
pickは、指定したカラム名の値を現在のリレーションから取得するときに利用できます。引数としてカラム名のリストを渡すと、指定したカラムの値の最初の行を、対応するデータ型で返します。
pickは、relation.limit(1).pluck(*column_names).firstのショートハンドです。主に、既に1行に制限されたリレーションがある場合に有用です。
pickを使うと、以下のようなコードをシンプルなものに置き換えられます。
Customer.where(id: 1).pluck(:id).first
上のコードは以下のように置き換えられます。
Customer.where(id: 1).pick(:id)
# => 1
idsは、テーブルの主キーを使ってリレーションの全IDを取り出すのに使えます。
store(dev)> Customer.ids
SELECT id FROM customers
別のprimary_keyを使っている場合は、その主キーが代わりに使われます。
class Customer < ApplicationRecord
  self.primary_key = "customer_id"
end
store(dev)> Customer.ids
SELECT customer_id FROM customers
レコードを検索し、レコードがなければ作成するという連続処理はよく行われます。
find_or_create_byおよびfind_or_create_by!メソッドを使えば、これらの処理を一度に行なえます。
find_or_create_byメソッドは、指定された属性を持つレコードが存在するかどうかをチェックします。レコードがない場合はcreateが呼び出されます。
"andy@example.com"というメールアドレスを持つ顧客(customer)を検索し、そのメールアドレスを持つ顧客が存在しない場合は、新たに作成したいとします。これは以下で実行できます。
store(dev)> Customer.find_or_create_by(email: "andy@example.com")
=> #<Customer id: 5, email: "andy@example.com", last_name: nil, title: nil, visits: 0, orders_count: nil, lock_version: 0, created_at: "2019-01-17 07:06:45", updated_at: "2019-01-17 07:06:45">
このメソッドによって生成されるSQLは以下のようになります。
SELECT *
  FROM customers
  WHERE (customers.email = "andy@example.com")
  LIMIT 1

BEGIN
INSERT INTO customers (created_at, email, locked, orders_count, updated_at) VALUES ("2011-08-30 05:22:57", "andy@example.com", 1, NULL, "2011-08-30 05:22:57")
COMMIT
find_or_create_byは、既にあるレコードか新しいレコードのいずれかを返します。
上の例の場合、指定のメールアドレスを持つ顧客が存在しなかったので、レコードを作成して返しました。
createなどと同様、バリデーションがパスするかどうかによって、新しいレコードがデータベースに保存されない可能性があります。
今度は、新しいレコードを作成するときにlocked属性をfalseに設定したいが、それをクエリに含めたくないとします。そこで、"andy@example.com"というメールアドレスを持つ顧客を検索するか、該当する顧客が存在しない場合は、そのメールアドレスを持つ顧客をロックなしで作成することにします。
これは2とおりの方法で実装できます。1つ目はcreate_withを使う方法です。
Customer.create_with(locked: false).find_or_create_by(email: "andy@example.com")
2つ目はブロックを使う方法です。
Customer.find_or_create_by(email: "andy@example.com") do |c|
  c.locked = false
end
このブロックは、顧客が作成されるときにだけ実行されます。このコードを再度実行すると、このブロックは実行されません。
find_or_create_byメソッドはアトミックでないため、競合状態が発生する可能性があります。コンカレントな処理の場合、2つのプロセスが同時にレコードが存在するかどうかを確認し、レコードが存在しないと判断して両方がレコードを作成しようとすると、重複レコードが発生する可能性があります。このような競合状態を回避するには、クエリ対象のデータベースカラムにUNIQUE制約を設定するか、UNIQUE制約違反をアトミックに処理できる後述のcreate_or_find_byメソッドの利用を検討してください。
find_or_create_by!を使うと、新しいレコードが無効な場合に例外を発生するようになります。バリデーション(検証)については本ガイドでは解説していませんが、たとえば以下のバリデーションを一時的にCustomerモデルに追加したとします。
validates :orders_count, presence: true
orders_countを指定せずに新しいCustomerモデルを作成しようとすると、レコードは無効になって以下のように例外が発生します。
store(dev)> Customer.find_or_create_by!(first_name: "Andy")
ActiveRecord::RecordInvalid: Validation failed: Orders count can't be blank
find_or_initialize_byメソッドはfind_or_create_byと同様に動作しますが、createではなくnewを呼ぶ点が異なります。
つまり、モデルの新しいインスタンスがメモリ上に作成されますが、データベースへの保存は行いません。
今度は'Nina'という名前の顧客を検索したいとします。
store(dev)> nina = Customer.find_or_initialize_by(first_name: "Nina")
=> #<Customer id: nil, first_name: "Nina", orders_count: 0, locked: true, created_at: "2011-08-30 06:09:27", updated_at: "2011-08-30 06:09:27">

store(dev)> nina.persisted?
=> false

store(dev)> nina.new_record?
=> true
オブジェクトはまだデータベースに保存されていないため、生成されるSQLは以下のようなものになります。
SELECT * FROM customers WHERE (customers.first_name = "Nina") LIMIT 1
このオブジェクトをデータベースに保存したい場合は、単にsaveを呼び出します。
store(dev)> nina.save
=> true
create_or_find_byメソッドは、指定の属性を持つレコードの作成を試みます。
指定の属性を持つレコードが既に存在する場合(UNIQUE制約違反を意味する)、既存のレコードを検索して返します。このメソッドの振る舞いはアトミックであり、find_or_create_byで起きる可能性のある競合状態を回避します。
store(dev)> Customer.create_or_find_by(first_name: "Andy")
=> #<Customer id: 5, first_name: "Andy", last_name: nil, title: nil, visits: 0, orders_count: nil, lock_version: 0, created_at: "2019-01-17 07:06:45", updated_at: "2019-01-17 07:06:45">
このメソッドを最初に呼び出すと、以下のようなSQLが生成されます。
BEGIN
INSERT INTO customers (created_at, first_name, locked, orders_count, updated_at) VALUES ("2011-08-30 05:22:57", "Andy", 1, NULL, "2011-08-30 05:22:57")
COMMIT
レコードが存在することが(UNIQUE制約によって)検出されると、作成は失敗し、代わりに既存のレコードを検索します。
BEGIN
INSERT INTO customers (created_at, first_name, locked, orders_count, updated_at) VALUES ("2011-08-30 05:22:57", "Andy", 1, NULL, "2011-08-30 05:22:57")
ROLLBACK

SELECT *
  FROM customers
  WHERE (customers.first_name = "Andy")
  LIMIT 1
create_or_find_byとfind_or_create_byの重要な違いは、操作の順序と、アトミックであるかどうかです。
create_or_find_byが正しく動作するには、クエリ対象の属性にUNIQUE制約が設定されていることが不可欠です。この制約がないと、メソッドは重複キー違反を引き起こす可能性があります。このメソッドは、「レコードの作成がほとんどのケースで成功することを期待する場合」「関連する属性に既にUNIQUE制約が設定されている場合」「重複レコードの原因となる可能性のある競合状態を回避したい場合」に最適です。
create_or_find_by!は、UNIQUE制約違反以外の理由でレコード作成が失敗した場合に例外を発生したい場合に利用できます。このメソッドはfind_or_create_by!と似ていますが、最初に作成を試みる点とアトミックである点が異なります。
store(dev)> Customer.create_or_find_by!(first_name: "Andy", orders_count: 5)
=> #<Customer id: 5, first_name: "Andy", orders_count: 5, ...>
レコード作成中に(UNIQUE制約違反以外の理由で)バリデーションが失敗すると、以下のように例外を発生します。
store(dev)> Customer.create_or_find_by!(first_name: "Andy", orders_count: nil)
ActiveRecord::RecordInvalid: Validation failed: Orders count can't be blank
ただし、UNIQUE制約違反で失敗した場合は例外を発生せず、通常通り既存のレコードを検索して返します(create_or_find_byと同様)。
レコードが1件以上存在するかどうかをチェックするには、以下のメソッドを利用できます。
レコードが存在するかどうかを、レコードをインスタンス化せずにチェックしたい場合は、exists?メソッドが使えます。
このメソッドは、findと同じクエリをデータベースに送信しますが、レコードやレコードのコレクションではなくtrueまたはfalseを返します。
store(dev)> Customer.exists?(1)
SELECT 1 AS one FROM customers WHERE customers.id = 1 LIMIT 1
=> true
exists?メソッドの引数には複数の値を渡せます。ただし、それらの値のうち1つでも存在していれば、他の値が存在していなくてもtrueを返します。
store(dev)> Customer.exists?(id: [1, 2, 3])
=> true
store(dev)> Customer.exists?(first_name: ["Jane", "Sergei"])
=> true
引数なしのexists?メソッドは、モデルやリレーションにも利用できます。
store(dev)> Customer.where(first_name: "Ryan").exists?
=> true
上の例では、first_nameが'Ryan'である顧客が1人でもいればtrueを返し、それ以外の場合はfalseを返します。
store(dev)> Customer.exists?
=> true
上の例では、customersテーブルが空ならfalseを返し、それ以外の場合はtrueを返します。
モデルやリレーションの存在チェックにはany?メソッドも使えます。
レコードが既にメモリ上に読み込み済みの場合、データベースにクエリを再送信せずにメモリ上のレコードをチェックします。
store(dev)> orders = Order.limit(10).load
SELECT orders.* FROM orders LIMIT 10
store(dev)> orders.any?
=> true
store(dev)> Order.any?
SELECT 1 FROM orders LIMIT 1
=> true

store(dev)> Order.shipped.any?
SELECT 1 FROM orders WHERE orders.status = 0 LIMIT 1
=> true

store(dev)> Book.where(out_of_print: true).any?
=> true

store(dev)> Customer.first.orders.any?
=> true
モデルやリレーションにレコードが2個以上存在するかどうかのチェックには、many?メソッドが使えます。レコードがメモリ上に読み込まれていない場合は、SQLのcountを使います。
store(dev)> Order.many?
SELECT COUNT(*) FROM (SELECT 1 FROM orders LIMIT 2)
=> true

store(dev)> Order.shipped.many?
SELECT COUNT(*) FROM (SELECT 1 FROM orders WHERE orders.status = 0 LIMIT 2)
=> true

store(dev)> Book.where(out_of_print: true).many?
=> true

store(dev)> Customer.first.orders.many?
=> true
大量のレコードに対して処理を反復したいことがあります(多くのユーザーにニュースレターを送信したい、データをエクスポートしたいなど)。
そうした処理を、つい以下のようにall.eachで書きたくなるかもしれません。
# このコードはテーブルが大きい場合にメモリを大量に消費する可能性あり
Customer.all.each do |customer|
  NewsMailer.weekly(customer).deliver_now
end
しかし上のような処理は、テーブルのサイズが大きくなるに従ってだんだん使い物にならなくなります。Customer.all.eachは、Active Recordに対して テーブル全体を一度に取り出し、しかも1行ごとにオブジェクトを生成し、その巨大なモデルオブジェクトの配列をメモリに配置するからです。このようなコードを大量のレコードに対してうかつに実行すると、コレクション全体のサイズがメモリ容量を上回ってしまう可能性があります。
Railsでは、メモリを圧迫しないサイズにバッチを分割して処理するために、2種類のメソッドを提供しています。
find_eachメソッドとfind_in_batchesメソッドは、一度にメモリに読み込めないような大量のレコードに対するバッチ処理のためのものです。千件程度のレコードに対して単純なループ処理を行うのであれば、通常の検索メソッドで十分です。
find_eachメソッドは、複数のレコードを一括で取り出し、続いて 各レコードをブロックにyieldします。以下の例では、find_eachは顧客を1,000件ずつのバッチで取り出し、各レコードをブロックにyieldします。
Customer.find_each do |customer|
  NewsMailer.weekly(customer).deliver_now
end
この処理は、必要に応じて次のレコードのバッチをフェッチし、すべてのレコードが処理されるまで繰り返されます。
find_eachメソッドは上述のようにモデルのクラスに対して機能しますが、順序付けされていないリレーションに対しても機能します。これは、メソッドが反復処理を行うために内部的に順序を強制する必要があるためです。
Customer.where(weekly_subscriber: true).find_each do |customer|
  NewsMailer.weekly(customer).deliver_now
end
リレーションが順序付けされている場合、このメソッドの振る舞いはconfig.active_record.error_on_ignored_orderフラグによって決まります。
このフラグがtrueに設定されている場合、ArgumentErrorが発生します。それ以外の場合は、順序は無視され、警告が表示されます。
これはデフォルトの動作ですが、後述の:error_on_ignoreオプションで上書きできます。
:batch_size
:batch_sizeオプションは、(ブロックに個別に渡される前に)1回のバッチで取り出すレコード数を指定します。たとえば、1回に5,000件ずつ処理したい場合は以下のように指定します。
Customer.find_each(batch_size: 5000) do |customer|
  NewsMailer.weekly(customer).deliver_now
end
:start
デフォルトでは、レコードは主キーの昇順で取り出されます。並び順冒頭のIDが不要な場合は、:startオプションを使ってシーケンスの開始IDを指定できます。これは、たとえば中断したバッチ処理を再開する場合などに便利です(最後に実行された処理のIDがチェックポイントとして保存済みであることが前提です)。
たとえば主キーが2,000番以降のユーザーに対してニュースレターを配信する場合は、以下のようになります。
Customer.find_each(start: 2000) do |customer|
  NewsMailer.weekly(customer).deliver_now
end
:finish
:startオプションと同様に、シーケンスの末尾のIDを指定したい場合は、:finishオプションで末尾のIDを設定できます。:startと:finishでレコードのサブセットを指定し、その中でバッチプロセスを走らせたい場合に便利です。
たとえば主キーが2,000番〜9,999番のユーザーに対してニュースレターを配信したい場合は、以下のようになります。
Customer.find_each(start: 2000, finish: 9999) do |customer|
  NewsMailer.weekly(customer).deliver_now
end
他にも、同じ処理キューを複数のワーカーで手分けする場合が考えられます。たとえばワーカーごとに10,000レコードずつ処理したい場合も、:startと:finishオプションにそれぞれ適切な値を設定することで実現できます。
:error_on_ignore
リレーション内に特定の順序があれば例外を発生させたい場合は、このオプションでアプリケーションの設定を上書きします。
:order
主キーの並び順(:ascまたは:desc)を指定します。デフォルト値は:ascです。
Customer.find_each(order: :desc) do |customer|
  NewsMailer.weekly(customer).deliver_now
end
find_in_batchesメソッドは、レコードをバッチで取り出すという点でfind_eachと似ています。違うのは、find_in_batchesはバッチを個別にではなくモデルの配列としてブロックにyieldするという点です。
以下の例では、与えられたブロックに対して一度に最大1,000人までの顧客(customer)の配列をyieldしています。最後のブロックには残りの顧客が含まれます。
# 1回あたり1,000人の顧客の配列をadd_customersに渡す
Customer.find_in_batches do |customers|
  export.add_customers(customers)
end
find_in_batchesメソッドは上述のようにモデルのクラスに対して機能するだけでなく、順序付けされていないリレーションに対しても機能します。その理由は、このメソッドが反復処理のために内部で強制的に順序付けする必要があるためです。
# 最近アクティブな顧客を1,000人ずつ配列にしてadd_customersに渡す
Customer.recently_active.find_in_batches do |customers|
  export.add_customers(customers)
end
find_in_batchesメソッドでは、find_eachメソッドと同様のオプションを使えます。
:batch_size
find_eachと同様に、batch_sizeはグループごとのレコード数を指定します。たとえば、レコードを2,500件ずつ取り出すには以下のように指定できます。
Customer.find_in_batches(batch_size: 2500) do |customers|
  export.add_customers(customers)
end
:start
startオプションを使うと、レコードがSELECTされるときの最初のIDを指定できます。上述のように、デフォルトではレコードを主キーの昇順でフェッチします。たとえば、ID: 5000から始まる顧客レコードを2,500件ずつ取り出すには、以下のようなコードが使えます。
Customer.find_in_batches(batch_size: 2500, start: 5000) do |customers|
  export.add_customers(customers)
end
:finish
finishオプションを使うと、レコードを取り出すときの末尾のIDを指定できます。以下は、ID: 7000までの顧客レコードをバッチで取り出す場合のコードです。
Customer.find_in_batches(finish: 7000) do |customers|
  export.add_customers(customers)
end
:error_on_ignore
リレーション内に特定の順序があれば例外を発生させたい場合は、error_on_ignoreオプションでアプリケーションの設定を上書きします。
whereメソッドは、返されるレコードを制限するための条件を指定します。SQL文で言うWHEREの部分に相当します。
条件は、「文字列」「配列」「ハッシュ」のいずれかの方法で与えられます。
検索メソッドに条件を追加したい場合、以下のようにwhereで直接指定できます。
Book.where("title = \"Introduction to Algorithms\"")
この場合、titleフィールドの値が'Introduction to Algorithms'であるすべての本が検索されます。
条件を文字列だけで構成すると、SQLインジェクションの脆弱性が発生する可能性があります。たとえば、Book.where("title LIKE '%#{params[:title]}%'")という書き方は危険です。次で説明するように、配列を使うのが望ましい方法です。詳しくは、セキュリティガイドのSQLインジェクションを参照してください。
条件が引数に依存している場合、以下のように配列で条件を指定できます。
Book.where(["title = ?", params[:title]])
渡せるのは実際の配列だけではありません。以下のように引数のリストも渡せます。
Book.where("title = ?", params[:title])
Active Recordは最初の引数を、文字列で表された条件として受け取ります。その後に続く引数は、文字列内にある疑問符?と置き換えられます。
Active Recordは、SQLインジェクションを防止するために、渡された値をエスケープし、必要に応じて適切なデータベース型に変換します。
以下のような安全でない文字列条件が使われると、意図しない危険なSQLが生成される可能性があります。
unsafe_title = "a' OR '1'='1"
Book.where("title = '#{unsafe_title}'")
以下のようにプレースホルダ?を介することで、値がエスケープされるようになります。
Book.where("title = ?", unsafe_title)
複数の条件を指定したい場合は次のようにします。
Book.where("title = ? AND out_of_print = ?", params[:title], false)
上の例では、1つ目の疑問符はparams[:title]のエスケープ済みの値で置き換えられ、2つ目の疑問符はfalseをSQL形式に変換したもので置き換えられます(変換方法はアダプタによって異なります)。
疑問符(?)をパラメータで置き換えるスタイルと同様に、名前付きプレースホルダを使って値のハッシュを渡す方法も利用できます。
Book.where("title = :title AND out_of_print = :out_of_print",
  title: params[:title], out_of_print: false)
このように書くことで、多数の変数を使う条件が読みやすくなります。
引数はSQLインジェクションを防ぐために自動的にエスケープされますが、SQL LIKEワイルドカード(つまり、%と_)はエスケープされません。引数にサニタイズされていない値が使われている場合、予期しない動作となることがあります。
以下の例をご覧ください。
Book.where("title LIKE ?", params[:title] + "%")
上の例は、ユーザーが指定した文字列で始まるタイトルに一致することを意図しています。しかし、params[:title]に含まれる%または_はワイルドカードとして扱われるため、予想外の結果をもたらします。状況によっては、データベースがインデックスを利用できなくなるため、クエリが大幅に遅くなる可能性があります。
これらの問題を回避するには、引数の該当部分にあるワイルドカード文字をsanitize_sql_likeでエスケープします。
Book.where("title LIKE ?",
  Book.sanitize_sql_like(params[:title]) + "%")
Active Recordは条件をハッシュで渡すこともできます。この書式を使うことで条件構文が読みやすくなります。条件をハッシュで渡す場合、ハッシュのキーには条件付けしたいフィールドを、ハッシュの値にはそのフィールドをどのように条件づけするかを、それぞれ指定します。
ハッシュによる条件を利用できるのは、等値、範囲、サブセットのチェックだけです。
Book.where(out_of_print: true)
これは以下のようなSQLを生成します。
SELECT * FROM books WHERE (books.out_of_print = true)
フィールド名は文字列でも指定できます。
Book.where("out_of_print" => true)
belongs_toリレーションシップの場合、Active Recordオブジェクトが値として使われていれば、モデルを指定する時に関連付けキーを利用できます。
この方法はポリモーフィックリレーションシップでも同様に利用できます。
author = Author.first
Book.where(author: author)
Author.joins(:books).where(books: { author: author })
ハッシュ条件は、以下のように「キーがカラムの配列である」かつ「値がタプルの配列である」タプル的な構文でも指定できます。
Book.where([:author_id, :id] => [[15, 1], [15, 2]])
この構文は、複合主キーを利用しているモデルで便利な場合があります。詳しくは複合主キーのガイドを参照してください。
Book.where(created_at: (Time.now.midnight - 1.day)..Time.now.midnight)
上の例では、昨日作成されたすべての本を検索します。内部ではSQLのBETWEEN文が使われます。
SELECT * FROM books WHERE (books.created_at BETWEEN "2008-12-21 00:00:00" AND "2008-12-22 00:00:00")
これは、条件を配列で指定するをさらに短い構文で表した例です。
Rubyの終端/始端を持たない範囲オブジェクト(beginless/endless range)がサポートされており、以下のように「〜より大きい」「〜より小さい」条件の構築で利用できます。
Book.where(created_at: (Time.now.midnight - 1.day)..)
上は、以下のようなSQLを生成します。
SELECT * FROM books WHERE books.created_at >= "2008-12-21 00:00:00"
SQLのIN式でレコードを検索したい場合、条件ハッシュにそのための配列を渡せます。
Customer.where(orders_count: [1, 3, 5])
上のコードを実行すると、以下のようなSQLが生成されます。
SELECT * FROM customers WHERE (customers.orders_count IN (1,3,5))
SQLのNOTクエリは、where.notで表せます。
Customer.where.not(orders_count: [1, 3, 5])
言い換えれば、このクエリはwhereに引数を付けずに呼び出し、直後にnotをチェインして、そこにwhere条件を渡すことで生成されています。これは以下のようなSQLを出力します。
SELECT * FROM customers WHERE (customers.orders_count NOT IN (1,3,5))
あるクエリのnull許容(nullable)カラムに、非nil値を指定したハッシュ条件がある場合、null許容カラムにnil値を持つレコードは返されません。
Customer.create!(nullable_country: nil)
Customer.where.not(nullable_country: "UK")
# => []

Customer.create!(nullable_country: "UK")
Customer.where.not(nullable_country: nil)
# => [#<Customer id: 2, nullable_country: "UK">]
2つのリレーションをまたいでOR条件を使いたい場合は、1つ目のリレーションでorメソッドを呼び出し、そのメソッドの引数に2つ目のリレーションを渡すことで実現できます。
Customer.where(last_name: "Smith").or(Customer.where(orders_count: [1, 3, 5]))
SELECT * FROM customers WHERE (customers.last_name = "Smith" OR customers.orders_count IN (1,3,5))
AND条件は、where条件をチェインすることで構成できます。
Customer.where(last_name: "Smith").where(orders_count: [1, 3, 5])
SELECT * FROM customers WHERE customers.last_name = "Smith" AND customers.orders_count IN (1,3,5)
リレーション間の論理的な交差(共通集合)を表すAND条件は、1個目のリレーションでandを呼び出し、その引数で2個目のリレーションを指定することで構成できます。
Customer.where(id: [1, 2]).and(Customer.where(id: [2, 3]))
SELECT * FROM customers WHERE (customers.id IN (1, 2) AND customers.id IN (2, 3))
データベースから取り出すレコードを特定の順序で並べ替えたい場合は、orderメソッドが使えます。
たとえば、ひとかたまりのレコードを取り出し、それをテーブル内のcreated_atの昇順で並べたい場合には以下のようにします。
Book.order(:created_at)
# または
Book.order("created_at")
ASC(昇順)やDESC(降順)も指定できます。
Book.order(created_at: :desc)
# または
Book.order(created_at: :asc)
# または
Book.order("created_at DESC")
# または
Book.order("created_at ASC")
複数のフィールドを指定して並べることもできます。
Book.order(title: :asc, created_at: :desc)
# または
Book.order(:title, created_at: :desc)
# または
Book.order("title ASC, created_at DESC")
# または
Book.order("title ASC", "created_at DESC")
orderメソッドを複数回呼び出すと、最初の並び順の後ろに以後の並び順が追加されていきます。
store(dev)> Book.order("title ASC").order("created_at DESC")
SELECT * FROM books ORDER BY title ASC, created_at DESC
以下のようにjoinしたテーブルで順序を指定することも可能です。
Book.includes(:author).order(books: { print_year: :desc }, authors: { name: :asc })
# または
Book.includes(:author).order("books.print_year desc", "authors.name asc")
多くのデータベースシステムでは、select、pluck、idsメソッドを使った結果をdistinctで絞り込んだとき、order句で指定したフィールドがselectのリストに含まれていないとActiveRecord::StatementInvalid例外が発生します。結果から特定のフィールドを取り出す方法については、次のセクションを参照してください。
ActiveRecord::Relationは、デフォルトでは結果セットからすべてのフィールドを選択します。内部的にはSQLのselect *が実行されています。
結果セットからフィールドのサブセットだけを取り出したい場合は、selectメソッドでサブセットを指定できます。
たとえば、isbnカラムとout_of_printカラムだけを取り出したい場合は以下のようにします。
Book.select(:isbn, :out_of_print)
# または
Book.select("isbn, out_of_print")
上の検索で実際に使われるSQL文は以下のようになります。
SELECT isbn, out_of_print FROM books
selectを実行して初期化されたモデルオブジェクトには、選択したフィールドしか含まれていないことに注意が必要です。
モデルオブジェクトの初期化時に指定しなかったフィールドにアクセスしようとすると、以下のメッセージが表示されます。
ActiveModel::MissingAttributeError: missing attribute '<属性名>' for Book
<属性名>は、アクセスしようとした属性です。idメソッドは、このActiveModel::MissingAttributeErrorを発生しません。
このため、関連付けを扱う場合にはご注意ください。関連付けが正常に動作するにはidメソッドが必要です。
データベースから取り出すレコード件数を制限するには、リレーションでlimitメソッドやoffsetメソッドを用いてLIMITを指定できます。
limitメソッドは、取り出すレコード数の上限を指定します。
offsetは、レコードを返す前にスキップするレコード数を指定します。
上を実行すると顧客が最大で5人返されます。オフセットは指定されていないので、最初の5つがテーブルから取り出されます。この時実行されるSQLは以下のような感じになります。
SELECT * FROM customers LIMIT 5
offsetを追加すると、最初の30件をスキップして31件目から最大5件のレコードを返します。
Customer.limit(5).offset(30)
このときのSQLは以下のようになります。
SELECT * FROM customers LIMIT 5 OFFSET 30
特定のフィールドについて、重複のない一意の値ごとに1レコードだけ取り出したい場合は、distinctが使えます。
Customer.select(:last_name).distinct
上のコードを実行すると、以下のようなSQLが生成されます。
SELECT DISTINCT last_name FROM customers
一意性の制約を外すこともできます。
# 一意のlast_namesを返す
query = Customer.select(:last_name).distinct

# 重複の有無を問わず、すべてのlast_namesを返す
query.distinct(false)
レコードをグループ化したい場合は、groupメソッドを検索メソッドに追加することで、生成されるSQLにGROUP BY句を適用できます。
たとえば、注文(order)のコレクションを検索してステータスでグループ化したい場合は、以下のようにします。
上のコードは、データベース内で一意のステータス値ごとにOrderオブジェクトを1つ返します。
上で実行されるSQLは以下のようなものになります。
SELECT *
  FROM orders
  GROUP BY status
グループごとの項目数を数えるには、groupに続けてcountを呼び出します。
store(dev)> Order.group(:status).count
=> {"being_packed"=>7, "shipped"=>12}
上で実行されるSQLは以下のようになります。
SELECT COUNT (*) AS count_all, status AS status
  FROM orders
  GROUP BY status
グループ化したクエリの結果をフィルタで絞り込むには、havingメソッドが使えます。
whereはグループ化の前に行をフィルタしますが、havingは集計後にグループをフィルタする点が異なります。
以下に例を示します。
Order.select("customer_id, sum(total) as total_price").
  group("customer_id").having("sum(total) > ?", 200)
上で生成されるSQLは以下のようになります。
SELECT customer_id, sum(total) as total_price
  FROM orders
  GROUP BY customer_id
  HAVING sum(total) > 200
これは、注文合計金額が200ドルを超える顧客ごとに、顧客IDと合計金額をグループ化して返します。
orderオブジェクトごとのtotal_priceにアクセスするには以下のように書きます。
big_orders = Order.select("customer_id, sum(total) as total_price")
                  .group("customer_id")
                  .having("sum(total) > ?", 200)

big_orders[0].total_price
# 最初のOrderオブジェクトの合計額が返される
既存のリレーションを基に構築するときに、クエリの一部を「条件の削除」「条件の置換」「レコードのselect方法や順序の再定義」によって変更したい場合があります。
Active Recordには、リレーション全体を最初から再構築しなくとも、個々のSQL句をオーバーライドできる方法がいくつも用意されています。
unscopeで特定の条件を取り除けます。以下に例を示します。
Book.where("id > 100").limit(20).order("id desc").unscope(:order)
上で生成されるSQLは以下のようになります。
SELECT *
  FROM books
  WHERE id > 100
  LIMIT 20

-- `unscope`する前のオリジナルのクエリ
SELECT *
  FROM books
  WHERE id > 100
  ORDER BY id desc
  LIMIT 20
unscopeで特定のwhere句を指定することも可能です。たとえば、以下はwhere句からid条件を取り除きます。
Book.where(id: 10, out_of_print: false).unscope(where: :id)
上で生成されるSQLは以下のようになります。
SELECT books.* FROM books WHERE out_of_print = false
unscopeを使ったリレーションは、マージ先のリレーションにも影響します。以下の例では、オリジナルのリレーションからorderが取り除かれます。
Book.order("id desc").merge(Book.unscope(:order))
上で生成されるSQLは以下のようになります。
SELECT books.* FROM books
何らかの理由でスコープをすべて解除したい場合はunscopedメソッドが使えます。このメソッドは、モデルで指定されているdefault_scopeを適用したくないクエリがある場合に特に便利です。
ただし、unscopedはスコープが存在しない場合でも利用できます。
このメソッドはスコープをすべて解除し、テーブルに対して通常の(スコープなしの)クエリを実行するようにします。
Book.where(out_of_print: true).unscoped.all
上の2つの例は、どちらも以下のSQLを生成します。
SELECT books.* FROM books
unscopedにはブロックも渡せます。
Book.unscoped { Book.out_of_print }
SELECT books.* FROM books WHERE books.out_of_print = true
以下のようにonlyメソッドを使って条件を上書きできます。
以下の例では:orderスコープと:whereスコープだけが適用され、:limitスコープは解除されます。
Book.where("id > 10").limit(20).order("id desc").only(:order, :where)
上で生成されるSQLは以下のようになります。
SELECT *
  FROM books
  WHERE id > 10
  ORDER BY id DESC

-- `only`を使う前のオリジナルのクエリ
SELECT *
  FROM books
  WHERE id > 10
  ORDER BY id DESC
  LIMIT 20
exceptメソッドを使うと、以下のように特定の条件を削除できます。
Book.where("id > 100").limit(20).order("id desc").except(:order)
生成されたSQLが実行されるときに、:order句は無視されます。
SELECT *
  FROM books
  WHERE id > 100
  LIMIT 20

-- `except`を使う前のオリジナルのクエリ
SELECT *
  FROM books
  WHERE id > 100
  ORDER BY id desc
  LIMIT 20
以下のように複数の条件を削除することも可能です。
Book.where("id > 100").limit(20).order("id desc").except(:order, :limit)
上で生成されるSQLは以下のようになります。
SELECT books.* FROM books WHERE id > 100
reselectメソッドを使うと、以下のように既存のselect文を上書きできます。
Book.select(:title, :isbn).reselect(:created_at)
上で生成されるSQLは以下のようになります。
SELECT books.created_at FROM books
reselect句を使わない場合と比較してみましょう。
Book.select(:title, :isbn).select(:created_at)
上で生成されるSQLは以下のようになります。
SELECT books.title, books.isbn, books.created_at FROM books
reorderメソッドは、それまでに定義されたorder句をすべて上書きします。たとえばクラス定義に以下があるとします。
class Book < ApplicationRecord
  default_scope { order(year_published: :desc) }
end
続いて以下を実行します。
上で生成されるSQLは以下のようになります。
SELECT *
  FROM books
  ORDER BY year_published DESC
reorderを使うと、以下のように別の並び順を指定できます。
Book.reorder("year_published ASC")
上で生成されるSQLは以下のようになります。
SELECT *
  FROM books
  ORDER BY year_published ASC
reorderメソッドは、デフォルトスコープの順序指定だけでなく、クエリチェインで事前に定義されたどの順序指定に対しても有効です。
Book.where("id > 100").order("id desc").reorder("title ASC")
上のようにすると、デフォルトスコープの順序指定と、その前のorder("id desc")が両方とも上書きされて、タイトルだけで並べ替えられます。
reverse_orderメソッドは、並び順が指定されている場合に並び順を逆にします。
Book.where("author_id > 10").order(:year_published).reverse_order
上で生成されるSQLは以下のようになります。
SELECT * FROM books WHERE author_id > 10 ORDER BY year_published DESC
SQLクエリで並び順を指定する句がない状態でreverse_orderを実行すると、主キーの逆順になります。
Book.where("author_id > 10").reverse_order
上で生成されるSQLは以下のようになります。
SELECT * FROM books WHERE author_id > 10 ORDER BY books.id DESC
このメソッドは引数を取りません。
rewhereメソッドは、以下のように既存の名前付きwhere条件を上書きします。
Book.where(out_of_print: true).rewhere(out_of_print: false)
実行されるSQLは以下のようになります。
SELECT * FROM books WHERE out_of_print = false
rewhereではなく、以下のようにwhereにすると、置き換えではなく、2つのwhere句のAND条件になります。
Book.where(out_of_print: true).where(out_of_print: false)
実行されるSQLは以下のようになります。
SELECT * FROM books WHERE out_of_print = true AND out_of_print = false
regroupメソッドは、既存の名前付きgroup条件をオーバーライドします。例:
Book.group(:author_id).regroup(:id)
実行されるSQLは以下のようになります。
SELECT * FROM books GROUP BY id
regroupではなく通常のgroupを使った場合、オーバーライドではなくgroup句同士が結合されます。
Book.group(:author_id).group(:id)
実行されるSQLは以下のようになります。
SELECT * FROM books GROUP BY author_id, id
noneメソッドは、チェイン(chain)可能なリレーションを返します(レコードは返しません)。このメソッドから返されたリレーションにどのような条件をチェインさせても、常に空のリレーションが生成されます。
これは、結果が0件になる可能性のあるメソッドやスコープで、チェイン可能なレスポンスが必要な場合に便利です。
Book.none # 空のリレーションを返し、クエリを生成しない
class Book
  # レビューが5件以上の場合にレビューを返す
  # それ以外の本はレビューなしとみなす
  def highlighted_reviews
    if reviews.count >= 5
      reviews
    else
      Review.none # レビュー5件未満の場合
    end
  end
end

# highlighted_reviewsメソッドは常にリレーションを返すことが期待されている
Book.first.highlighted_reviews.average(:rating)
# => 本1冊あたりの平均レーティングを返す(レビュー数が5件未満であっても)
Active Recordがリレーションで提供するreadonlyメソッドは、返されたどのレコードについても改変を明示的に禁止します。読み取り専用のオブジェクトに対する改変の試みはすべて失敗し、ActiveRecord::ReadOnlyRecord例外が発生します。
customer = Customer.readonly.first
customer.visits += 1
customer.save # ActiveRecord::ReadOnlyRecordがraiseされる
上のコードではcustomerに対して明示的にreadonlyが指定されているため、visitsの値を更新してcustomer.saveを行なうとActiveRecord::ReadOnlyRecord例外が発生します。
ロックは、データベースのレコードを更新する際の競合状態を避け、アトミックな(=中途半端な状態のない)更新を行なうために有用です。
アトミックな操作とは、完全に実行されるか、まったく実行されないかのいずれかであり、部分的な更新が他のプロセスから見えることを防ぐ操作のことです。
Active Recordには2とおりのロック機構があります。
- 楽観的ロック(optimistic locking)
- 悲観的ロック(pessimistic locking)
楽観的ロックでは、複数のユーザーが同じレコードを編集のために開くことを許し、データの衝突は最小限であると想定します。レコードを開いてから別のプロセスが変更を加えていないかをチェックし、変更が発生した場合は、ActiveRecord::StaleObjectError例外がスローされ、更新は無視されます。
楽観的ロックを使うには、テーブルにlock_versionという名前のinteger型カラムが必要です。Active Recordは、レコードが更新されるたびにlock_versionカラムの値を1ずつ増やします。
更新リクエストが発生したときのlock_versionの値がデータベース上のlock_versionカラムの値よりも小さい場合、更新リクエストは失敗し、以下のようにActiveRecord::StaleObjectErrorエラーが発生します。
c1 = Customer.find(1)
c2 = Customer.find(1)

c1.first_name = "Sandra"
c1.save

c1.lock_version # => 1
c2.lock_version # => 0

c2.first_name = "Michael"
c2.save # ActiveRecord::StaleObjectErrorが発生
開発者は、例外の発生後にこの例外をrescueして衝突を解決する責任があります。
衝突の解決方法は、ロールバック、マージ、またはビジネスロジックに応じた解決方法のいずれかをお使いください。
ActiveRecord::Base.lock_optimistically = falseを設定するとこの動作をオフにできます。
ActiveRecord::Baseには、lock_versionカラム名を上書きするためのlocking_column属性が用意されています。
class Customer < ApplicationRecord
  self.locking_column = :lock_customer_column
end
悲観的ロックでは、データベースが提供するロック機構を利用します。リレーションの構築時にlockを使うと、選択した行に対する排他的ロックを取得できます。lockを用いているリレーションは、デッドロック条件を回避するために、通常トランザクションの内側にラップされます。
以下に例を示します。
Book.transaction do
  book = Book.lock.first
  book.title = "Algorithms, second edition"
  book.save!
end
バックエンドがMySQLの場合、上のセッションによって以下のSQLが生成されます。
SQL (0.2ms)   BEGIN
Book Load (0.3ms)   SELECT * FROM books LIMIT 1 FOR UPDATE
Book Update (0.4ms)   UPDATE books SET updated_at = "2009-02-07 18:05:56", title = "Algorithms, second edition" WHERE id = 1
SQL (0.8ms)   COMMIT
ロックの種別を変更したい場合は、lockメソッドに生SQLを渡すことも可能です。たとえば、MySQLにはLOCK IN SHARE MODE(レコードのロック中にも他のクエリからの読み出しを許可する)という式があります。
この式を指定するには、以下のように単にlockオプションの引数で渡します。
Book.transaction do
  book = Book.lock("LOCK IN SHARE MODE").find(1)
  book.increment!(:views)
end
この機能を使うには、lockメソッドで渡す生SQLがデータベースでサポートされていなければなりません。サポートされていない場合はActiveRecord::StatementInvalid例外が発生します。
モデルのインスタンスが既にある場合は、with_lockメソッドを使うことで、トランザクションの開始とロックの取得を一度に行えます。
ブロックは現在のトランザクションを受け取るので、以下のようにコールバックを登録できます。
book = Book.first
# yieldする前にbookをロック付きで再読み込みする
book.with_lock do |transaction|
  # このブロックはトランザクション内で呼び出される
  # bookはロック済み
  transaction.after_commit { puts "hello" }
  book.increment!(:views)
end
テーブルの結合(JOIN)を使うと、1件のクエリで複数のテーブルからレコードを取得できます。たとえば、書籍(books)とその著者(authors)をまとめて取得できます。
Active RecordはJOIN句のSQLを具体的に指定するために、joinsとleft_outer_joinsという2つの検索メソッドを提供しています。
-
joinsメソッド:INNER JOINを行うクエリや、カスタムクエリで使う
-
left_outer_joinsメソッド: LEFT OUTER JOINを行うクエリで使う
joinsメソッドには複数の使い方があります。
joinsメソッドの引数に生のSQLを指定することでJOIN句を指定できます。
Author.joins("INNER JOIN books ON books.author_id = authors.id AND books.out_of_print = FALSE")
これによって以下のSQLが生成されます。
SELECT authors.* FROM authors
  INNER JOIN books ON books.author_id = authors.id AND books.out_of_print = FALSE
Active Recordでは、関連付けでjoinsメソッドを利用してJOIN句を指定する際に、モデルで定義されている関連付け名をショートカットとして利用できます。
以下のすべてにおいて、INNER JOINによる結合クエリが期待どおりに生成されます。
関連付け名(:reviews)を渡すことで単一のテーブルを結合します。
上によって以下が生成されます。
SELECT books.* FROM books
  INNER JOIN reviews ON reviews.book_id = books.id
上のSQLクエリは、レビュー付きのすべての本についてBookのレコードを返します。
本1冊にレビューが2件以上ついている場合は、本が重複表示される点にご注意ください。重複のない一意の本を表示したい場合は、Book.joins(:reviews).distinctが使えます。
関連付け名を複数(:author、:reviews)渡すことで、複数のテーブルを結合します。
Book.joins(:author, :reviews)
上によって以下が生成されます。
SELECT books.* FROM books
  INNER JOIN authors ON authors.id = books.author_id
  INNER JOIN reviews ON reviews.book_id = books.id
上のSQLクエリは、著者があり、かつレビューが1件以上ついているすべての本を返します。
本1冊にレビューが2件以上ついている場合は、本が重複表示される点にご注意ください。重複のない一意の本を表示したい場合は、Book.joins(:reviews).distinctが使えます。
関連付け名をハッシュ形式で渡すことで、テーブルを別の結合済みテーブルに結合できます。
Book.joins(reviews: :customer)
上によって以下が生成されます。
SELECT books.* FROM books
  INNER JOIN reviews ON reviews.book_id = books.id
  INNER JOIN customers ON customers.id = reviews.customer_id
上のSQLクエリは、顧客がレビューを付けたすべての本を返します。
より複雑な結合を行いたい場合は、ハッシュと配列を組み合わせて指定します。
Author.joins(books: [{ reviews: { customer: :orders } }, :supplier])
上によって以下のSQLクエリが生成されます。
SELECT authors.* FROM authors
  INNER JOIN books ON books.author_id = authors.id
  INNER JOIN reviews ON reviews.book_id = books.id
  INNER JOIN customers ON customers.id = reviews.customer_id
  INNER JOIN orders ON orders.customer_id = customers.id
  INNER JOIN suppliers ON suppliers.id = books.supplier_id
上のSQLクエリは、「"注文したことのある顧客によるレビュー"と"仕入先"(supplier)の両方を持つ本の、すべての著者」を返します。
結合テーブルに条件を指定するときには、標準の配列や文字列条件を利用できます。
ハッシュ条件の場合は、結合テーブルで条件を指定するときに特殊な構文を使います。
time_range = (Time.now.midnight - 1.day)..Time.now.midnight
Customer.joins(:orders).where("orders.created_at" => time_range).distinct
上は、created_atをSQLのBETWEEN式で比較することで、昨日注文を行ったすべての顧客を検索できます。
以下のようにハッシュ条件をネストさせると、さらに読みやすくなります。
time_range = (Time.now.midnight - 1.day)..Time.now.midnight
Customer.joins(:orders).where(orders: { created_at: time_range }).distinct
さらに高度な条件指定や既存の名前付きスコープの再利用を行いたい場合は、mergeを利用してもよいでしょう。
最初に、Orderモデルに新しい名前付きスコープを追加してみましょう。
class Order < ApplicationRecord
  belongs_to :customer

  scope :created_in_time_range, ->(time_range) {
    where(created_at: time_range)
  }
end
これで、created_in_time_rangeスコープをmergeでマージできるようになります。
time_range = (Time.now.midnight - 1.day)..Time.now.midnight
Customer.joins(:orders).merge(Order.created_in_time_range(time_range)).distinct
上も、SQLのBETWEEN式で比較することで、昨日注文を行ったすべての顧客を検索できます。
INNER JOINでは、関連付けられたレコードを持つレコードのみが返されます。
関連レコードがあるかどうかにかかわらずレコードのセットを取得したい場合は、left_outer_joinsメソッドを使います。
Customer.left_outer_joins(:reviews).distinct.select("customers.*, COUNT(reviews.*) AS reviews_count").group("customers.id")
上のコードは、以下のSQLクエリを生成します。
SELECT DISTINCT customers.*, COUNT(reviews.*) AS reviews_count FROM customers
  LEFT OUTER JOIN reviews ON reviews.customer_id = customers.id
  GROUP BY customers.id
上のSQLクエリは、レビュー投稿の有無にかかわらずすべての顧客を対象とし、それぞれの顧客情報とレビューの投稿数を返します。
associatedクエリメソッドとmissingクエリメソッドは、それぞれ関連付けが「存在する場合」や「存在しない場合」に基づいてレコードのコレクションをSELECTできます。
where.associatedを使うには、以下のように最初にwhereを引数なしで記述し、それに続けて関連付け名を指定したassociatedを記述します。
Customer.where.associated(:reviews)
上によって以下のSQLクエリが生成されます。
SELECT customers.* FROM customers
  INNER JOIN reviews ON reviews.customer_id = customers.id
  WHERE reviews.id IS NOT NULL
このSQLクエリは、レビューを1件以上投稿したすべての顧客を返します。
where.missingは、where.associatedと逆の動作です。where.missingを使うと、関連付けを持たないレコードをSELECTできます。
Customer.where.missing(:reviews)
上によって以下のSQLクエリが生成されます。
SELECT customers.* FROM customers
  LEFT OUTER JOIN reviews ON reviews.customer_id = customers.id
  WHERE reviews.id IS NULL
このSQLクエリは、レビューをまったく投稿していないすべての顧客を返します。
joinが既に定義済みの場合、associatedでそのjoinが使われます。
# associatedは、このクエリではJOINではなくLEFT JOINを使う
Post.left_joins(:author).where.associated(:author)
eager-loading(一括読み込み)とは、ActiveRecord::Relationから返されるオブジェクトに関連付けられたレコードを、できるだけパフォーマンスの高いクエリで読み込むためのメカニズムです。
1件のクエリでN個のレコード(Nは1より大きい数)のリストを取得すると、レコード1件につき1個のクエリが発行され、合計でN個の追加クエリが発生する場合があります。
以下のコードについて考えてみましょう。このコードは、本を10冊検索して著者のlast_nameを表示します。
books = Book.limit(10)

books.each do |book|
  puts book.author.last_name
end
このコードは一見何の問題もないように見えます。しかし本当の問題は、実行されたクエリの回数が無駄に多いことなのです。
上のコードでは、最初に本を10冊検索するクエリを1回発行し、次にそこからlast_nameを取り出すのにクエリを10回発行しますので、合計で 11 回のクエリが発行されます。
Active Recordでは、以下のメソッドを用いることで、読み込まれるすべての関連付けを事前に指定できます。
includesを指定すると、Active Recordは指定されたすべての関連付けをできるだけパフォーマンスの高いクエリで読み込むようになります。
上の例で言うと、以下のようにincludesメソッドを使う形に書き直すことで、著者(author)がeager-loading(一括読み込み)されます。
books = Book.includes(:author).limit(10)

books.each do |book|
  puts book.author.last_name
end
最初の例では 11 回もクエリが実行されましたが、書き直した例ではわずか 2 回にまで減りました。
SELECT books.* FROM books
  LIMIT 10

SELECT authors.* FROM authors
  WHERE authors.id IN (1,2,3,4,5,6,7,8,9,10)
Active Recordは、1回のActiveRecord::Relation呼び出しで、関連付けをいくつでもeager-loading(一括読み込み)できます。
これを行なうには、includesメソッドに「配列」「ハッシュ」または「配列やハッシュをネストしたハッシュ」を渡します。
複数の関連付けをeager-loadingするには、以下のように関連付け名を配列として渡します。
Customer.includes(:orders, :reviews)
上のコードは、すべての顧客を読み込むとともに、顧客ごとに関連付けられている注文やレビューも読み込みます。
ネストした関連付けをeager-loadingするには、以下のようにハッシュを渡します。
Customer.includes(orders: { books: [:supplier, :author] }).find(1)
上のコードは、id=1の顧客を検索し、関連付けられたすべての注文、すべての注文に対応する書籍、そして各書籍の著者と仕入先をeager-loadingします。
Active Recordでは、eager-loadingされた関連付けに条件も指定可能ですが、この方法よりもjoinsを使うことをオススメします。
とはいえ、eager-loadingされた関連付けに対して条件を指定せざるを得ない場合は、以下のように普通にwhereを使っても大丈夫です。
Author.includes(:books).where(books: { out_of_print: true })
上のコードは、以下のようにLEFT OUTER JOINを含むクエリを1件生成します。joinsメソッドを使うと、代わりにINNER JOINを使うクエリが生成されます。
  SELECT authors.id AS t0_r0, ... books.updated_at AS t1_r5 FROM authors
    LEFT OUTER JOIN books ON books.author_id = authors.id
    WHERE (books.out_of_print = true)
where条件がない場合は、通常のクエリが2つ生成されます。
whereがこのように動作するのは、ハッシュを渡した場合だけです。SQLフラグメント文字列を渡す場合には、強制的に結合テーブルとして扱うためにreferencesを使う必要があります。
Author.includes(:books).where("books.out_of_print = true").references(:books)
このincludesクエリでは、仮にどの著者にも本がない場合でも、すべての著者が引き続き読み込まれます。
joins(INNER JOIN)を使う場合、結合条件は必ずマッチしなければならず 、それ以外の場合にはレコードは返されません。
関連付けがjoinの一部としてeager-loadingされている場合、読み込んだモデルの中にカスタマイズされたselect句のフィールドが存在しなくなります。これは親レコードと子レコードのどちらに現れるべきかが曖昧なためです。
includesの利用が推奨されます。includesは、クエリに応じて個別のクエリとLEFT OUTER JOINを使い分ける、より高機能なメソッドです。
preloadを使うと、Active Recordは指定された関連付けを、1つの関連付けにつき1件のクエリで読み込みます。
これは、条件がない場合のincludesの振る舞いと完全に同じです。
N+1クエリ問題が発生した場合で再び説明すると、以下のようにBook.limit(10)をpreloadメソッドで書き換えることで著者(author)をプリロードできます。
books = Book.preload(:author).limit(10)

books.each do |book|
  puts book.author.last_name
end
書き換え前は 11 回もクエリが実行されましたが、書き直した上のコードはわずか 2 回にまで減りました。
SELECT books.* FROM books
  LIMIT 10

SELECT authors.* FROM authors
  WHERE authors.id IN (1,2,3,4,5,6,7,8,9,10)
「配列」「ハッシュ」または「配列やハッシュをネストしたハッシュ」を用いるpreloadメソッドは、includesメソッドと同様に1件のActiveRecord::Relation呼び出しで任意の個数の関連付けを読み込みます。シンプルなケースでは、includesメソッドと同じ戦略を取ります。ただしincludesメソッドと異なり、プリロードされる関連付けに条件を指定できません。
eager_loadメソッドを使うと、Active Recordは、指定されたすべての関連付けをLEFT OUTER JOINで読み込みます。
N+1クエリ問題が発生した場合で再び説明すると、以下のようにBook.limit(10)をeager_loadメソッドで書き換えることで著者(author)をeager-loadingできます。
books = Book.eager_load(:author).limit(10)

books.each do |book|
  puts book.author.last_name
end
書き換え前は11回もクエリが実行されましたが、書き直した上のコードはわずか1回にまで減りました。
SELECT "books"."id" AS t0_r0, "books"."title" AS t0_r1, ... FROM "books"
  LEFT OUTER JOIN "authors" ON "authors"."id" = "books"."author_id"
  LIMIT 10
「配列」「ハッシュ」または「配列やハッシュをネストしたハッシュ」を用いるeager_loadメソッドは、includesメソッドと同様に1件のActiveRecord::Relation呼び出しで任意の個数の関連付けを読み込みます。また、includesメソッドと同様に、eager-loadingされる関連付けに条件を指定できます。
eager-loadingはN+1クエリを防止できますが、いくつかの関連付けを遅延読み込み(lazy-loading)している可能性もあります。strict_loadingを有効にすることで、関連付けを遅延読み込みしなくなります。
リレーションでstrict_loadingモードを有効にすると、レコードが任意の関連付けを遅延読み込みしようとしたときにActiveRecord::StrictLoadingViolationErrorが発生します。
user = User.strict_loading.first
user.address.city  # ActiveRecord::StrictLoadingViolationErrorが発生
user.comments.to_a # ActiveRecord::StrictLoadingViolationErrorが発生
すべてのリレーションでstrict_loadingを有効にするには、config.active_record.strict_loading_by_defaultフラグをtrueに変更します。
config.active_record.strict_loading_by_default = true
違反をロガーに送信するには、config.active_record.action_on_strict_loading_violationを:logに変更します。
config.active_record.action_on_strict_loading_violation = :log
以下のように、レコード自身でstrict_loading!を呼び出すことでstrict-loading(強制読み込み)を有効にすることも可能です。
user = User.first
user.strict_loading!
user.address.city  # ActiveRecord::StrictLoadingViolationErrorが発生
user.comments.to_a # ActiveRecord::StrictLoadingViolationErrorが発生
strict_loading!メソッドには:mode引数も渡せます。
:n_plus_one_onlyを指定すると、N+1クエリを引き起こす関連付けが遅延読み込みされた場合にのみエラーをraiseするようになります。
user.strict_loading!(mode: :n_plus_one_only)
user.address.city # => "Tatooine"
user.comments.to_a # => [#<Comment:0x00...]
user.comments.first.likes.to_a # ActiveRecord::StrictLoadingViolationErrorをraiseする
以下のようにstrict_loadingオプションを指定することで、単一の関連付けに対してstrict-loadingを有効にすることも可能です。
class Author < ApplicationRecord
  has_many :books, strict_loading: true
end
よく使うクエリをスコープに設定しておくと、関連オブジェクトやモデルへのメソッド呼び出しとして参照できるようになります。スコープでは、where、joins、includesなど、これまでに登場したメソッドをすべて使えます。
別のスコープなどのメソッドをスコープ上で呼び出せるようにするため、スコープ本体は常にActiveRecord::Relationかnilのいずれかを返すべきです。
シンプルなスコープを設定するには、以下のようにクラスの内部にscopeメソッドを書き、スコープが呼び出されたときに実行したいクエリをそこで渡します。
class Book < ApplicationRecord
  scope :out_of_print, -> { where(out_of_print: true) }
end
作成したout_of_printスコープは、以下のようにクラスメソッドとして呼び出せます。
store(dev)> Book.out_of_print
=> #<ActiveRecord::Relation> # すべての絶版の本
あるいは、以下のようにBookオブジェクトを用いる関連付けでも呼び出せます。
store(dev)> author = Author.first
store(dev)> author.books.out_of_print
=> #<ActiveRecord::Relation> # `author`によるすべての絶版の本
スコープには以下のように引数を渡せます。
class Book < ApplicationRecord
  scope :costs_more_than, ->(amount) { where("price > ?", amount) }
end
引数付きスコープの呼び出しは、クラスメソッドの呼び出しと同様です。
store(dev)> Book.costs_more_than(100.10)
ただし、スコープに引数を渡す機能は、クラスメソッドによって提供される機能を単に複製したものです。
class Book < ApplicationRecord
  def self.costs_more_than(amount)
    where("price > ?", amount)
  end
end
スコープとして定義したメソッドは、関連付けオブジェクトからもアクセス可能です。
store(dev)> author.books.costs_more_than(100.10)
スコープで条件文を使うことも可能です。
class Order < ApplicationRecord
  scope :created_before, ->(time) { where(created_at: ...time) if time.present? }
end
他の例と同様、これもクラスメソッドのように振る舞います。
class Order < ApplicationRecord
  def self.created_before(time)
    where(created_at: ...time) if time.present?
  end
end
ただし、1つ重要な注意点があります。スコープは、条件文を評価した結果がfalseであっても、常にActiveRecord::Relationオブジェクトを返します。クラスメソッドの場合はnilを返すので、この点において振る舞いが異なります。
したがって、条件文を使うクラスメソッドをチェインし、かつ、条件文のいずれかがfalseを返す場合、NoMethodErrorを発生する可能性があります。
条件がfalseと評価された場合にselfを返すことで、クラスメソッドをスコープと同じ振る舞いにできます(常にActiveRecord::Relationを返す)。
class Order < ApplicationRecord
  def self.created_before(time)
    if time.present?
      where(created_at: ...time)
    else
      self
    end
  end
end
こうすることで、このクラスメソッドは常にActiveRecord::Relationオブジェクトを返すようになるので、スコープと同様に安全にチェインできます。
あるスコープをモデルのすべてのクエリに適用したい場合、モデル自身の内部でdefault_scopeメソッドを使えます。
class Book < ApplicationRecord
  default_scope { where(out_of_print: false) }
end
このモデルに対してクエリが実行されたときのSQLクエリは以下のような感じになります。
SELECT * FROM books WHERE (out_of_print = false)
デフォルトスコープの条件が複雑になる場合は、以下のようにスコープをクラスメソッドとして定義してもよいでしょう。
class Book < ApplicationRecord
  def self.default_scope
    # ActiveRecord::Relationを返すべき
  end
end
スコープの引数がHashで与えられると、レコードを作成・ビルドするときにdefault_scopeも適用されます。ただし、レコードを更新する場合は適用されません。
たとえば、out_of_printをfalseに設定するdefault_scopeがある状況で、out_of_print属性をtrueに設定した新しい書籍を作成すると、default_scopeが適用されます。
class Book < ApplicationRecord
  default_scope { where(out_of_print: false) }
end
store(dev)> Book.new
=> #<Book id: nil, out_of_print: false>
store(dev)> Book.unscoped.new
=> #<Book id: nil, out_of_print: nil>
ただし、引数がArrayとして渡されると、default_scopeクエリの引数はHashのデフォルト値に変換されない点に注意が必要です。
class Book < ApplicationRecord
  default_scope { where("out_of_print = ?", false) }
end
store(dev)> Book.new
=> #<Book id: nil, out_of_print: nil>
複数のスコープを順に呼び出す場合、where句の場合と同様に、スコープもAND条件でマージできます。
class Book < ApplicationRecord
  scope :in_print, -> { where(out_of_print: false) }
  scope :out_of_print, -> { where(out_of_print: true) }

  scope :old, -> { where(year_published: ...50.years.ago.year) }
end
store(dev)> Book.out_of_print.old
SELECT books.* FROM books WHERE books.out_of_print = "true" AND books.year_published < 1969
スコープから別のスコープを呼び出すことも可能です。
class Book < ApplicationRecord
  scope :out_of_print, -> { where(out_of_print: true) }
  scope :old, -> { where(year_published: ...50.years.ago.year) }
  scope :out_of_print_and_old, -> { out_of_print.old }
end
scopeとwhere条件は自由に組み合わせられます。このとき生成される最終的なSQLでは、以下のようにすべての条件がANDで結合されます。
store(dev)> Book.in_print.where(price: ...100)
SELECT books.* FROM books WHERE books.out_of_print = "false" AND books.price < 100
末尾のwhere句を直前のscopeより優先したい場合は、mergeが使えます。
store(dev)> Book.in_print.merge(Book.out_of_print)
SELECT books.* FROM books WHERE books.out_of_print = true
ただし、1つ重要な注意点があります。default_scopeで定義した条件は、以下のようにscopeやwhereで定義した条件の前方に追加されます。
class Book < ApplicationRecord
  default_scope { where(year_published: 50.years.ago.year..) }

  scope :in_print, -> { where(out_of_print: false) }
  scope :out_of_print, -> { where(out_of_print: true) }
end
store(dev)> Book.all
SELECT books.* FROM books WHERE (year_published >= 1969)

store(dev)> Book.in_print
SELECT books.* FROM books WHERE (year_published >= 1969) AND books.out_of_print = false

store(dev)> Book.where(year_published: 2020)
SELECT books.* FROM books WHERE (year_published >= 1969) AND (year_published = 2020)
上の例でわかるように、default_scopeは、scope条件とwhereの条件の両方でマージされています。
scopingメソッドを使うと、現在のリレーションの条件を一時的にブロック内で適用できます。ブロック内で実行されるすべてのクエリで、そのリレーションのスコープが使われるようになります。
Order.where(customer_id: 1).scoping do
  Order.first
end

# SELECT "orders".* FROM "orders" WHERE "orders"."customer_id" = ? ORDER BY "orders"."id" ASC LIMIT ?  [["customer_id", 1], ["LIMIT", 1]]
上の例では、ブロックがリレーションのスコープ内で実行されるため、customer_id: 1という条件が自動的に適用されます。
scopingは、デフォルトではfirstやlastやwhereなどの検索メソッド(finderメソッド)のみに適用されます。
個別のレコードに対するupdateやdeleteなどを含む「すべてのクエリ」に対してスコープが効くようにしたい場合は、all_queries: trueオプションを指定します。
Order.where(customer_id: 1).scoping(all_queries: true) do
  order = Order.first
  order.update(status: :complete)
end

# Order Load (0.1ms)    SELECT "orders".* FROM "orders" WHERE "orders"."customer_id" = ? ORDER BY "orders"."id" ASC LIMIT ?  [["customer_id", 1], ["LIMIT", 1]]
# TRANSACTION (0.0ms)   BEGIN immediate TRANSACTION
# Order Update (0.1ms)  UPDATE "orders" SET "status" = ?, "updated_at" = ? WHERE "orders"."id" = ? AND "orders"."customer_id" = ?  [["status", 2], ["updated_at", "2025-11-25 11:26:16.089553"], ["id", 1], ["customer_id", 1]]
# TRANSACTION (0.0ms)   COMMIT TRANSACTION
これにより、ブロック内で実行されるすべてのクエリに対してcustomer_id: 1条件が適用されます。
scopingブロックでall_queries: trueが指定されると、その内側のブロックでall_queries: falseを指定しても解除できません。
Order.where(customer_id: 1).scoping(all_queries: true) do
  # ArgumentErrorが発生する
  Order.scoping(all_queries: false) do
    # ...
  end
end
何らかの理由でスコープをすべて解除したい場合はunscopedメソッドが使えます。このメソッドは、モデルで指定されているdefault_scopeを適用したくないクエリがある場合に特に便利です。
class Book < ApplicationRecord
  default_scope { where(out_of_print: false) }

  scope :in_print, -> { where(out_of_print: false) }
  scope :out_of_print, -> { where(out_of_print: true) }
end
このメソッドはスコープをすべて解除し、テーブルに対して通常の(スコープなしの)クエリを実行するようにします。
store(dev)> Book.unscoped.all
SELECT books.* FROM books

store(dev)> Book.where(out_of_print: true).unscoped.all
SELECT books.* FROM books
unscopedにはブロックも渡せます。ブロック内では、それまでに設定されたスコープがどのクエリにも適用されなくなります。
store(dev)> Book.in_print.unscoped { Book.out_of_print }

SELECT books.* FROM books WHERE books.out_of_print = true
属性で使う値を、事前定義済みの値リストのみに制限したい場合があります。
enumを使うと、属性で使う値を配列で定義して名前で参照できるようになります。値がデータベースに実際に保存されるときは、値に対応する整数値が保存されます。
enumを宣言すると、enumに設定可能なすべての値に対して「スコープ」「述語メソッド」「セッターメソッド」が作成されます。例:
class Order < ApplicationRecord
  enum :status, [:shipped, :being_packaged, :complete, :cancelled]
end
上のenumが宣言されると、個別のenum値に対して自動的にスコープが作成され、statusに特定の値が設定されている(もしくは設定されていない)すべてのレコードを検索できるようになります。
store(dev)> Order.shipped
=> #<ActiveRecord::Relation> # status == :shippedを満たすすべての注文
store(dev)> Order.not_shipped
=> #<ActiveRecord::Relation> # status != :shippedを満たすすべての注文
enumの各値に対応する述語メソッド(?で終わるメソッド)も自動で作成されます。
述語メソッドは、モデルのstatus enumにその値があるかどうかを以下のようにtrue/falseで返します。
store(dev)> order = Order.shipped.first
store(dev)> order.shipped?
=> true
store(dev)> order.complete?
=> false
enumの各値に対応する!付きのインスタンスメソッドも自動で作成されます。
enum値の名前を持つインスタンスメソッドを呼び出すと、まずstatusの値が指定の値に更新され、次にstatusの値が指定された値で正常に更新されたかどうかを返します。
store(dev)> order = Order.first
store(dev)> order.shipped!
UPDATE "orders" SET "status" = ?, "updated_at" = ? WHERE "orders"."id" = ?  [["status", 0], ["updated_at", "2019-01-24 07:13:08.524320"], ["id", 1]]
=> true
enumの完全なドキュメントについてはActiveRecord::Enumを参照してください。
Active Recordは、データベース上でさまざまな計算を実行するメソッドをサポートしています。これらのメソッドで計算する場合、ActiveRecordモデルをインスタンス化する必要はありません。
一般に、結果の計算はデータベースで実行する方が高速です。
このセクションではcountメソッドを例に説明しますが、同じパターンがすべての計算メソッドに当てはまります。
すべての計算メソッドは、モデルに対して直接実行できます。
store(dev)> Customer.count
SELECT COUNT(*) FROM customers
# => 3753
リレーションに対しても直接実行できます。
store(dev)> Customer.where(first_name: "Ryan").count
SELECT COUNT(*) FROM customers WHERE (first_name = "Ryan")
# => 17
この他にも、リレーションに対してさまざまな検索メソッドを利用して複雑な計算を行なえます。
store(dev)> Customer.includes("orders").where(first_name: "Ryan", orders: { status: "shipped" }).count
上のコードは以下のSQLを実行します。
SELECT COUNT(DISTINCT customers.id) FROM customers
  LEFT OUTER JOIN orders ON orders.customer_id = customers.id
  WHERE (customers.first_name = "Ryan" AND orders.status = 0)
上は、Orderモデルにenum status: [ :shipped, :being_packed, :cancelled ]が設定されていることが前提です。
モデルのテーブルに含まれるレコードの件数を数えたいときは、Customer.countを呼び出すことでレコードの件数が返されます。
データベースで肩書き(title)を持つ顧客だけを数えたいときは、以下のように:titleを渡します。
テーブルに含まれる特定の数値の平均を得るには、そのテーブルを持つクラスでaverageメソッドを呼び出します。このメソッド呼び出しは以下のようになります。
Order.average("subtotal")
# => 3.14159265
テーブルに含まれるフィールドの最小値を得るには、そのテーブルを持つクラスでminimumメソッドを呼び出します。このメソッド呼び出しは以下のようになります。
Order.minimum("subtotal")
# => 123.45
テーブルに含まれるフィールドの最大値を得るには、そのテーブルを持つクラスに対してmaximumメソッドを呼び出します。このメソッド呼び出しは以下のようになります。
Order.maximum("subtotal")
# => 4567.89
テーブルに含まれるフィールドのすべてのレコードにおける合計を得るには、そのテーブルを持つクラスに対してsumメソッドを呼び出します。このメソッド呼び出しは以下のようになります。
Order.sum("subtotal")
# => 12345.67
リレーションに対してexplainを実行できます。EXPLAINの出力形式はデータベースによって異なります。
以下の例は、リレーションに対してexplainを実行する方法を示しています。
Customer.where(id: 1).joins(:orders).explain
出力結果は、データベースアダプタによって変わります。
たとえば、MySQLとMariaDBでは、以下のような結果が生成されます。
EXPLAIN SELECT `customers`.* FROM `customers` INNER JOIN `orders` ON `orders`.`customer_id` = `customers`.`id` WHERE `customers`.`id` = 1
+----+-------------+------------+-------+---------------+
| id | select_type | table      | type  | possible_keys |
+----+-------------+------------+-------+---------------+
|  1 | SIMPLE      | customers  | const | PRIMARY       |
|  1 | SIMPLE      | orders     | ALL   | NULL          |
+----+-------------+------------+-------+---------------+
+---------+---------+-------+------+-------------+
| key     | key_len | ref   | rows | Extra       |
+---------+---------+-------+------+-------------+
| PRIMARY | 4       | const |    1 |             |
| NULL    | NULL    | NULL  |    1 | Using where |
+---------+---------+-------+------+-------------+

2 rows in set (0.00 sec)
Active Recordは、対応するデータベースシェルの出力をエミュレーションして読みやすく整形します。
そのため、同じクエリをPostgreSQLアダプタで実行すると、以下のような結果が得られます。
EXPLAIN SELECT "customers".* FROM "customers" INNER JOIN "orders" ON "orders"."customer_id" = "customers"."id" WHERE "customers"."id" = $1 [["id", 1]]
                                  QUERY PLAN
------------------------------------------------------------------------------
 Nested Loop  (cost=4.33..20.85 rows=4 width=164)
    ->  Index Scan using customers_pkey on customers  (cost=0.15..8.17 rows=1 width=164)
          Index Cond: (id = "1"::bigint)
    ->  Bitmap Heap Scan on orders  (cost=4.18..12.64 rows=4 width=8)
          Recheck Cond: (customer_id = "1"::bigint)
          ->  Bitmap Index Scan on index_orders_on_customer_id  (cost=0.00..4.18 rows=4 width=0)
                Index Cond: (customer_id = "1"::bigint)
(7 rows)
eager-loadingを使うと、内部的には複数のクエリがトリガーされることがあり、このとき一部のクエリで先行クエリの結果が必要になることがあります。
このため、explainは、このクエリを実際に実行してから、クエリプランを要求します。以下に例を示します。
Customer.where(id: 1).includes(:orders).explain
MySQLとMariaDBでは、以下の結果を生成します。
EXPLAIN SELECT `customers`.* FROM `customers`  WHERE `customers`.`id` = 1
+----+-------------+-----------+-------+---------------+
| id | select_type | table     | type  | possible_keys |
+----+-------------+-----------+-------+---------------+
|  1 | SIMPLE      | customers | const | PRIMARY       |
+----+-------------+-----------+-------+---------------+
+---------+---------+-------+------+-------+
| key     | key_len | ref   | rows | Extra |
+---------+---------+-------+------+-------+
| PRIMARY | 4       | const |    1 |       |
+---------+---------+-------+------+-------+

1 row in set (0.00 sec)

EXPLAIN SELECT `orders`.* FROM `orders`  WHERE `orders`.`customer_id` IN (1)
+----+-------------+--------+------+---------------+
| id | select_type | table  | type | possible_keys |
+----+-------------+--------+------+---------------+
|  1 | SIMPLE      | orders | ALL  | NULL          |
+----+-------------+--------+------+---------------+
+------+---------+------+------+-------------+
| key  | key_len | ref  | rows | Extra       |
+------+---------+------+------+-------------+
| NULL | NULL    | NULL |    1 | Using where |
+------+---------+------+------+-------------+


1 row in set (0.00 sec)
PostgreSQLの場合は以下のような結果を生成します。
  Customer Load (0.3ms)  SELECT "customers".* FROM "customers" WHERE "customers"."id" = $1  [["id", 1]]
  Order Load (0.3ms)  SELECT "orders".* FROM "orders" WHERE "orders"."customer_id" = $1  [["customer_id", 1]]
=> EXPLAIN SELECT "customers".* FROM "customers" WHERE "customers"."id" = $1 [["id", 1]]
                                    QUERY PLAN
----------------------------------------------------------------------------------
 Index Scan using customers_pkey on customers  (cost=0.15..8.17 rows=1 width=164)
   Index Cond: (id = "1"::bigint)
(2 rows)
explainにさまざまな計算メソッド(count、first、last、average、maximum、minimum、sum、pluck など)をチェインすることで、それらの操作のクエリプランを表示できます。
Customer.where(active: true).explain.count
Customer.order(:created_at).explain.first
データベースとそれをサポートするアダプタ(現在はPostgreSQL、MySQL、MariaDB)については、より深い分析を行うためのオプションも渡せます。
PostgreSQLの場合は以下のようになります。
Customer.where(id: 1).joins(:orders).explain(:analyze, :verbose)
上のコードは以下を生成します。
EXPLAIN (ANALYZE, VERBOSE) SELECT "shop_accounts".* FROM "shop_accounts" INNER JOIN "customers" ON "customers"."id" = "shop_accounts"."customer_id" WHERE "shop_accounts"."id" = $1 [["id", 1]]
                                                                   QUERY PLAN
------------------------------------------------------------------------------------------------------------------------------------------------
 Nested Loop  (cost=0.30..16.37 rows=1 width=24) (actual time=0.003..0.004 rows=0 loops=1)
   Output: shop_accounts.id, shop_accounts.customer_id, shop_accounts.customer_carrier_id
   Inner Unique: true
   ->  Index Scan using shop_accounts_pkey on public.shop_accounts  (cost=0.15..8.17 rows=1 width=24) (actual time=0.003..0.003 rows=0 loops=1)
         Output: shop_accounts.id, shop_accounts.customer_id, shop_accounts.customer_carrier_id
         Index Cond: (shop_accounts.id = "1"::bigint)
   ->  Index Only Scan using customers_pkey on public.customers  (cost=0.15..8.17 rows=1 width=8) (never executed)
         Output: customers.id
         Index Cond: (customers.id = shop_accounts.customer_id)
         Heap Fetches: 0
 Planning Time: 0.063 ms
 Execution Time: 0.011 ms
(12 rows)
MySQLまたはMariaDBの場合は、以下のようになります。
Customer.where(id: 1).joins(:orders).explain(:analyze)
上のコードは以下を生成します。
ANALYZE SELECT `shop_accounts`.* FROM `shop_accounts` INNER JOIN `customers` ON `customers`.`id` = `shop_accounts`.`customer_id` WHERE `shop_accounts`.`id` = 1
+----+-------------+-------+------+---------------+------+---------+------+------+--------+----------+------------+--------------------------------+
| id | select_type | table | type | possible_keys | key  | key_len | ref  | rows | r_rows | filtered | r_filtered | Extra                          |
+----+-------------+-------+------+---------------+------+---------+------+------+--------+----------+------------+--------------------------------+
|  1 | SIMPLE      | NULL  | NULL | NULL          | NULL | NULL    | NULL | NULL | NULL   | NULL     | NULL       | no matching row in const table |
+----+-------------+-------+------+---------------+------+---------+------+------+--------+----------+------------+--------------------------------+
1 row in set (0.00 sec)
EXPLAINやANALYZEのオプションは、MySQLやMariaDBのバージョンによって異なります。
EXPLAINの出力を解釈することは、本ガイドの範疇を超えます。
以下の情報を参考にしてください。
🖋 GitHubで編集を提案する
/
📕 英語で読む
Railsガイドは GitHub の yasslab/railsguides.jp で管理・公開されております。本ガイドを読んで気になる文章や間違ったコードを見かけたら、気軽に Pull Request を出して頂けると嬉しいです。Pull Request の送り方については GitHub の README をご参照ください。
原著における間違いを見つけたら『Rails のドキュメントに貢献する』を参考にしながらぜひ Rails コミュニティに貢献してみてください 🛠💨✨
本ガイドの品質向上に向けて、皆さまのご協力が得られれば嬉しいです。
Railsガイド運営チーム (@RailsGuidesJP)

Railsガイドは下記の協賛企業から継続的な支援を受けています。もしご興味あれば、協賛プランから気軽にお問い合わせいただけると嬉しいです。
- Star
-

-